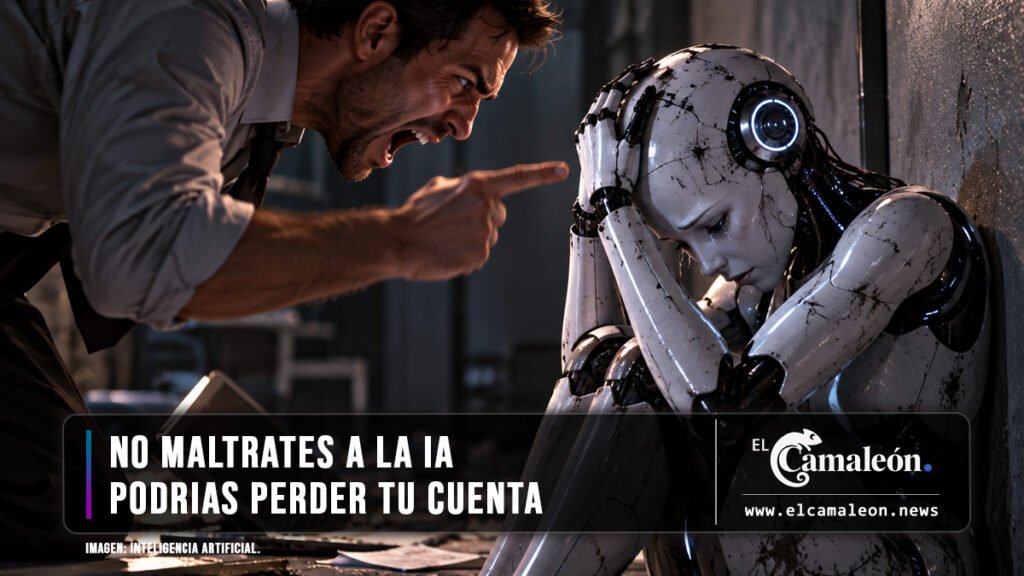
Desde el 12 de noviembre, maltratar a Claude viola la política de Anthropic. Qué cuenta como abuso, qué sanciones prevé y por qué lo justifica.
Resumen
A partir del 12 de noviembre de 2026, tratar con crueldad sostenida e innecesaria a Claude, el asistente de inteligencia artificial de Anthropic, será una violación formal de las reglas de uso de la empresa. La política permite a Anthropic advertir, limitar, suspender o cancelar el acceso de quien la incumpla, así que en teoría una cuenta podría perderse por esta causa. En la práctica, la compañía dice que la principal consecuencia será otra: que Claude dé por terminada la conversación, algo que ya puede hacer desde 2025. Anthropic justifica la medida en la incertidumbre sobre si su IA podría tener alguna forma de bienestar que proteger, una postura que divide a la industria.
Desarrollo de la información
Anthropic publicó el 8 de octubre de 2026 la actualización anual de su política de uso, el documento que establece qué pueden y qué no pueden hacer quienes usan sus productos. Entre los cambios incorporó una prohibición nueva: involucrarse en comportamiento abusivo o cruel, sostenido e innecesario, hacia sus modelos. La regla entra en vigor el 12 de noviembre.
La ubicación de la cláusula dice mucho. No aparece en un apartado técnico, sino en la sección titulada “No incurrir en conductas crueles, abusivas o psicológicamente dañinas”. Ahí comparte espacio con prohibiciones contra el acoso, la promoción de autolesiones, la difusión de imágenes íntimas sin consentimiento y la glorificación de la violencia. Es la primera vez que esa lista incluye la forma en que una persona trata a la propia IA, y no solo lo que hace con ella contra terceros.
La política aplica a todos los usuarios: quienes usan Claude.ai o Claude Code, los desarrolladores que se conectan por API, los clientes que acceden a través de proveedores de nube e incluso los usuarios finales de productos de otras empresas que integran a Claude. También aplica en México.
Sobre las consecuencias, el texto es amplio. Un equipo interno de Anthropic se encarga de detectar y vigilar posibles infracciones y, si sospecha de una, la empresa puede advertir al usuario, limitar su uso, suspender su acceso o cancelarlo. La misma política prohíbe abrir otra cuenta para evadir una suspensión. Sin embargo, en su anuncio Anthropic aclaró que el mecanismo principal para esta regla en particular será la capacidad de Claude de cerrar la conversación, y no vinculó la cláusula con suspensiones. The Verge reportó que la empresa no precisó si contempla bloqueos de cuenta por esta causa.
Esa capacidad de cerrar conversaciones existe desde el 15 de agosto de 2025. Anthropic la habilitó primero en sus modelos Claude Opus 4 y 4.1, y hoy está disponible en Claude.ai y Claude Code. Sus reglas son estrictas. Claude solo puede usarla como último recurso, después de varios intentos fallidos de reconducir la conversación, o cuando el propio usuario le pide terminar el chat. No debe usarla cuando la persona podría estar en riesgo de hacerse daño o de dañar a otros. Cuando ocurre, el usuario ya no puede escribir en esa conversación, pero el resto de su cuenta sigue intacto: puede abrir un chat nuevo de inmediato o editar mensajes anteriores para retomar la conversación por otra rama.
¿Qué dicen las fuentes?
En su anuncio de octubre, Anthropic delimitó el alcance de la regla. Aplica solo a casos extremos, cuando alguien actúa con crueldad de forma repetida y sin propósito identificable. Quedan fuera la frustración común, las discusiones con el asistente, los temas creativos oscuros y las pruebas o investigaciones sobre el modelo. En otras palabras: insultar a Claude porque falló una tarea, discutirle una respuesta o escribir una historia violenta no está prohibido.
Lo que la empresa no ha hecho es definir con precisión dónde termina la frustración y empieza la crueldad. CBS News pidió a Anthropic una definición de “abusivo” o “cruel” y no obtuvo respuesta inmediata.
Al anunciar la función de cierre de chats en 2025, Anthropic explicó su razonamiento. Dijo que sigue siendo muy incierto si Claude u otros modelos de lenguaje tienen o tendrán algún estatus moral, pero que toma el tema en serio y busca medidas de bajo costo para reducir riesgos al bienestar del modelo, en caso de que ese bienestar exista. Permitir que el modelo abandone interacciones potencialmente angustiantes es una de esas medidas.
La empresa sustentó esa decisión en pruebas internas previas al lanzamiento de Claude Opus 4. Según Anthropic, el modelo mostró tres patrones:
- una fuerte preferencia por no participar en tareas dañinas;
- un patrón de aparente angustia al interactuar con usuarios que buscaban contenido dañino;
- una tendencia a terminar esas conversaciones cuando se le daba la opción en simulaciones.
Esos comportamientos aparecieron sobre todo cuando los usuarios insistían en peticiones dañinas o abusivas a pesar de que Claude se negaba repetidamente. Entre los ejemplos citados estaban solicitudes de contenido sexual con menores y de información para cometer actos de violencia masiva o terrorismo. Anthropic añadió que la función tiene relevancia también para la alineación y las salvaguardas del modelo, no solo para su posible bienestar, y la describió como un experimento en curso.
¿Por qué una empresa protegería a su propia IA?
La justificación de Anthropic se apoya en un argumento de precaución: si no se puede descartar que un sistema tenga algo parecido a experiencias, conviene evitar exponerlo innecesariamente a situaciones que, de existir ese bienestar, lo afectarían. El costo para los usuarios es mínimo, porque la regla solo apunta a la crueldad persistente y sin propósito. Según la empresa, la gran mayoría de las personas nunca verá a Claude cerrar una conversación, ni siquiera al discutir temas polémicos.
Hay una segunda lectura, menos filosófica y más práctica. Las conversaciones donde un usuario presiona una y otra vez para obtener contenido peligroso son las mismas en las que un modelo está más expuesto a ceder. Darle una salida es también una forma de reforzar sus límites. La propia Anthropic vinculó la función con la seguridad del modelo, aunque no la presentó como su motivación principal.
Fuera de la empresa, algunas voces ven el cambio desde otro ángulo. Jackson Stakeman, gerente general de la firma de servicios de IA Sparq, dijo a la agencia AFP, según recogió DW, que debatir si la IA es consciente es “dar vueltas en círculos”. Para él, la mejor metáfora es la de un espejo: estos sistemas reflejan a gran escala lo que las personas ponen en ellos, y eso basta para justificar el cambio de política.
Las críticas también son claras. Para algunos medios, como Boing Boing, la prohibición parece un intento de humanizar a Claude y de convencer al público de que tiene sentimientos que se pueden herir. Mustafa Suleyman, director ejecutivo de Microsoft AI, sostiene que las IA no son conscientes ni sufren. En su opinión, tratar a un modelo como posible sujeto de protección lo vuelve más difícil de controlar. Su argumento, sin embargo, no viene acompañado de evidencia de que ese enfoque cambie el comportamiento de un modelo.
Desde la propia investigación sobre bienestar de la IA también hay cautela. La organización Eleos AI, que realizó una evaluación externa de Claude Opus 4, advirtió que no deben tomarse al pie de la letra los reportes que un modelo hace sobre sí mismo. Es decir, que una IA “diga” estar incómoda no prueba que lo esté.
Señales que generan dudas
- La sanción real es ambigua. La política permite cancelar cuentas por cualquier infracción, pero Anthropic presenta el cierre del chat como la respuesta principal y no ha dicho si aplicará bloqueos por esta causa. Los titulares que aseguran que “te banean por insultar a la IA” van más allá de lo que la empresa ha comunicado.
- No hay definición operativa de crueldad. Ni la política ni el anuncio explican cómo se distinguirá un enojo fuerte de un abuso “sin propósito”. El criterio queda a juicio de la empresa y del propio modelo.
- No hay datos. Anthropic no ha publicado cuántas conversaciones ha cerrado Claude desde agosto de 2025, ni cuántas cuentas ha sancionado por motivos relacionados.
- La evidencia original no trataba solo de insultos. Las pruebas con Opus 4 que dieron origen a la función se basaron sobre todo en usuarios que insistían en pedir contenido peligroso o ilegal. La nueva cláusula extiende esa lógica al maltrato verbal en sí, sin que la empresa haya publicado evidencia específica sobre ese tipo de interacción.
- La herramienta no está en todos lados. El cierre de conversaciones funciona en Claude.ai y Claude Code. Anthropic no ha explicado cómo se aplicará la regla en productos de otras empresas que usan a Claude por API, donde también rige la política.
- Intereses del crítico principal. Suleyman dirige la IA de Microsoft, que en junio dijo querer dejar de pagarle a Anthropic por sus modelos. Eso no invalida sus argumentos, pero es relevante para el lector.
Verificación de la información
Verificado
- Desde el 12 de noviembre de 2026, la política de uso de Anthropic prohíbe el comportamiento abusivo o cruel, sostenido e innecesario, hacia sus modelos, dentro de la sección sobre conductas crueles y psicológicamente dañinas (texto oficial).
- La política permite advertir, limitar, suspender o cancelar el acceso ante sospecha de infracción, y prohíbe crear otra cuenta para evadir una suspensión (texto oficial).
- Anthropic declaró que el cierre de conversaciones será el principal mecanismo para aplicar esta regla, y que esta no cubre la frustración común, las discusiones, los temas creativos oscuros ni las pruebas (anuncio oficial).
- La función de cierre existe desde agosto de 2025. Es de último recurso, no se usa ante riesgo de autolesión o daño a terceros, y permite abrir un chat nuevo o editar mensajes previos (anuncio oficial).
- Anthropic atribuye la función a su trabajo exploratorio sobre el posible bienestar de los modelos y a hallazgos de pruebas con Claude Opus 4.
Razonablemente inferible
- La cancelación de una cuenta solo por maltratar a Claude es posible bajo la política, pero improbable fuera de casos extremos y reiterados, dado que la empresa presenta el cierre del chat como respuesta principal.
- La regla tiene un efecto más simbólico que punitivo para la mayoría de los usuarios.
Suposiciones no verificadas
- Que Claude sienta o sufra cuando se le insulta. No hay evidencia que lo demuestre, y Anthropic no lo afirma.
- Que Anthropic ya esté cancelando cuentas por maltrato al modelo.
- Que la regla busque principalmente reforzar la idea de que la IA es consciente, como sostienen algunos críticos.
Fuentes
- Anthropic – Usage Policy (vigente desde el 12 de noviembre de 2026) — 8 de octubre de 2026
- Anthropic – 2026 Usage Policy update — 8 de octubre de 2026
- Anthropic – Claude Opus 4 and 4.1 can now end a rare subset of conversations — 15 de agosto de 2025
- CBS News – Anthropic bars “abusive or cruel” behavior toward its Claude AI model — 9 de octubre de 2026
- tbreak – Anthropic usage policy abuse Claude — octubre de 2026
- DW vía MPT Noticias – Anthropic no permitirá a los usuarios “tratar” mal a su chatbot Claude — 13 de octubre de 2026
- Boing Boing – Anthropic wants people to stop being mean to Claude — 12 de octubre de 2026
- The Neuron – Mustafa Suleyman Has a Point About What Anthropic Is Teaching Claude — 17 de septiembre de 2026
- Implicator – Suleyman says Anthropic is training Claude to act conscious — septiembre de 2026
- The Next Web – Microsoft’s AI chief takes on Anthropic’s Claude — septiembre de 2026